ШІ розшифровує мільйони сторінок середньовічних рукописів

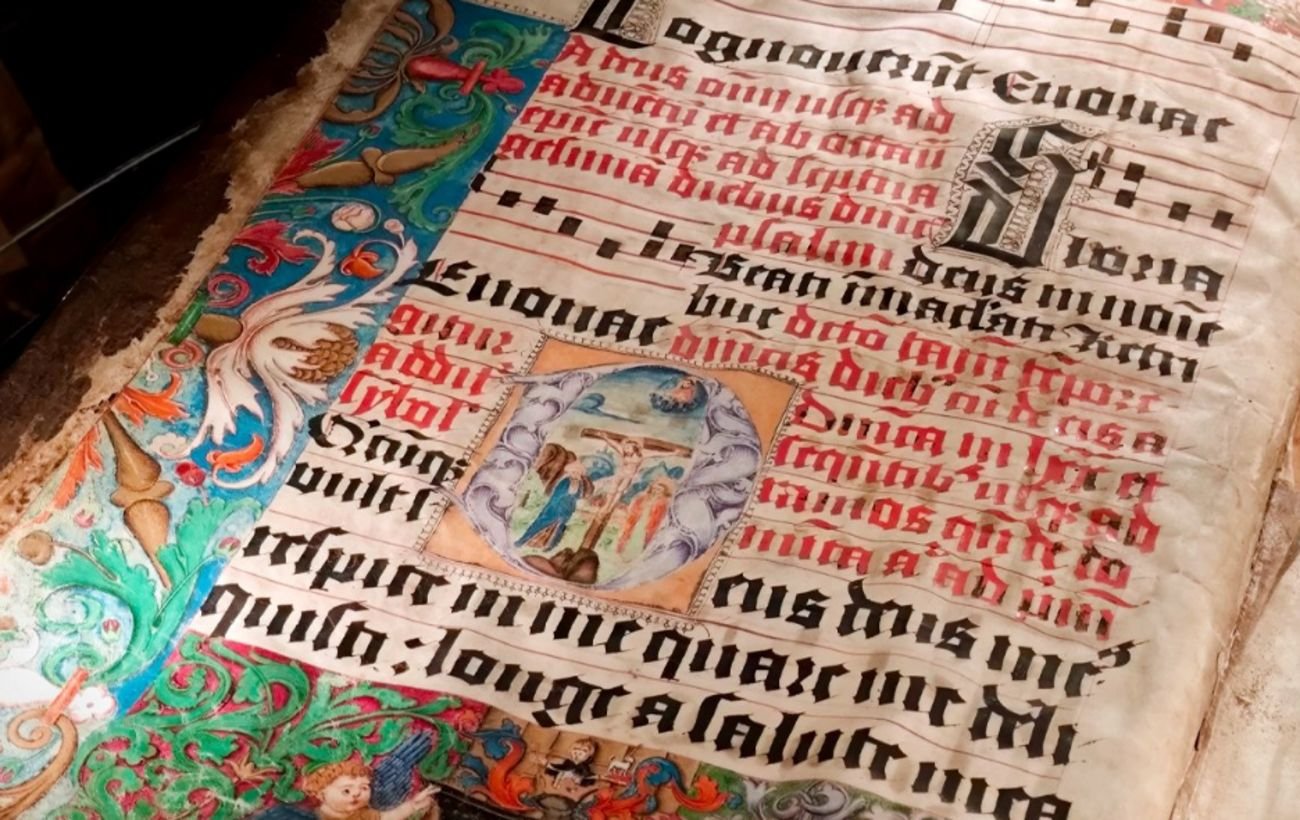
Науковці зібралися у Відні, щоб обговорити технічну основу майбутніх систем штучного інтелекту для роботи з історичними документами. Саміт організували Austrian Academy of Sciences та University of Vienna за підтримки Princeton University. У центрі уваги були автоматичне розшифрування рукописів, перевірка точності транскрипцій і способи надійного аналізу великих цифрових архівів.
Чому середньовічні рукописи складно оцифровувати
Робота з давніми документами вимагає значно більше, ніж простого розпізнавання символів. Дослідникам доводиться мати справу з незвичною графікою, пошкодженим пергаментом, вицвілим чорнилом і різними стилями письма.
Додаткову складність створюють застарілі мовні форми, скорочення та діалекти, які зникли з ужитку. Через це навіть досвідченому фахівцеві може знадобитися багато годин, щоб точно прочитати кілька сторінок.
Як штучний інтелект читає старовинні тексти
Нові ШІ-системи поєднують кілька технологій. Їх навчають не лише розпізнавати окремі знаки, а й враховувати особливості письма, мови та матеріалу, на якому створено документ.
- Нейромережеве розпізнавання почерку (HTR). Моделі тренують на великій кількості рукописів певної епохи або конкретного архіву. Завдяки цьому вони можуть відновлювати нерозбірливі символи, розрізняти індивідуальні манери писарів і працювати з частково пошкодженими сторінками.
- Автоматична транскрипція та нормалізація. Алгоритм переносить текст із рукопису в цифровий формат, розшифровує традиційні скорочення та, за потреби, подає слова у формі, зрозумілій сучасному читачеві. Оригінальне написання при цьому можна зберегти окремим шаром.
- Аналіз мультиспектральних зображень. Сканування у різних діапазонах світла допомагає виявити сліди чорнила, які не видно на звичайній фотографії. Це особливо важливо для палімпсестів — рукописів, поверхню яких очищали й використовували повторно.
Такі інструменти істотно прискорюють роботу, однак не скасовують участі істориків і філологів. Експерти мають перевіряти сумнівні фрагменти, адже алгоритм може помилитися через рідкісне слово, незвичне скорочення або пошкодження сторінки.
Від окремих манускриптів до аналізу цілих архівів
Найважливіша зміна полягає не лише у швидшому читанні одного документа. Цифрові технології дають змогу аналізувати великі масиви джерел одночасно — від сотень тисяч до мільйонів сторінок.
Алгоритми Big Data можуть шукати повторювані імена, топоніми, дати, мовні конструкції та взаємні згадки між документами. Так дослідники виявляють зв’язки, які було б майже неможливо помітити під час послідовного ручного опрацювання архіву.
Що це дає історикам
- допомагає швидко знаходити згадки про маловідомих людей і місця;
- дає змогу зіставляти документи, створені в різних регіонах;
- виявляє спільні мовні та адміністративні шаблони;
- допомагає відновлювати послідовність подій за розрізненими джерелами;
- створює цифрові карти зв’язків між рукописами, архівами та історичними постатями.
У результаті дослідники можуть перейти від вивчення окремих артефактів до комплексного аналізу цілих історичних процесів. Дані з різних куточків світу об’єднуються в єдині цифрові системи, де потрібні збіги та закономірності знаходяться за секунди, а не за роки ручної роботи.
Штучний інтелект не замінює фахівців, але істотно розширює їхні можливості. Поєднання нейромережевого розпізнавання, мультиспектрального сканування та аналізу великих даних може зробити середньовічні архіви доступнішими й допомогти точніше відтворити події минулого.